结论前置:能效榜单不是排名游戏,而是边界地图
按公开规格书与行业白皮书口径整理,端侧AI芯片的能效表现大致呈现「专用存算一体 > 近存计算 > 大核NPU > 小核多簇 > 通用GPU降频 > 纯CPU推理」的梯队分布。看球网技术解读栏目要提醒的是,这个排序只在特定工作负载与功耗包络下成立,一旦换到高精度训练微调或超大模型分片场景,榜单顺序会明显重排。因此本期盘点不给出「谁第一」的绝对结论,而是把六类方案放进同一张参数索引表,标注各自的能效甜点区与失效边界。
看球网在整理这份榜单时采用三条统一口径:其一,能效统一折算为每瓦有效算力,测试负载覆盖视觉检测、语音唤醒、轻量语言模型三类典型端侧任务;其二,所有数据来自厂商公开规格书、行业组织白皮书与公开评测文档,无法核验的项标注为示例数据;其三,榜单只反映架构层面的一般规律,不代表任何具体量产芯片的最终表现。
榜单主体:六类架构方案的能效梯队与参数索引
第一梯队是存算一体方案,在低功耗常开场景下能效优势最明显,适合语音唤醒、传感器前端处理这类数据搬运占比极高的任务。它的边界在于精度与可编程性,面向复杂算子时往往需要外部协处理器兜底。看球网建议读者把这类方案理解为「专用加速器」而非「通用算力」。
- 存算一体:能效甜点区为常开感知与轻量分类,失效边界是高精度矩阵运算与动态形状输入。
- 近存计算:在中等算力区间平衡了带宽与功耗,适合图像预处理与中等规模卷积网络,边界在于片上存储容量受限时的性能塌陷。
- 大核NPU:单核算力密度高,适合多路视频分析与中等参数模型,边界是功耗峰值较高、散热设计难度上升。
- 小核多簇:调度灵活、待机功耗低,适合多任务并发与碎片化负载,边界是单任务大模型推理效率不足。
- 通用GPU降频:生态成熟、算子覆盖全,适合算法快速迭代期,边界是能效比在端侧长期运行中不占优。
- 纯CPU推理:部署门槛最低、兼容性最好,适合低频次轻量推理,边界是吞吐与能效均处于榜单末位。
看球网在参数索引中特别标注了一项容易被忽略的指标:能效榜单的测试结果对片上存储容量高度敏感。同一架构在不同存储配置下,能效差距可能超过一个梯队,这也是很多选型争议的真正来源。
选型边界:榜单之外的三条判断线
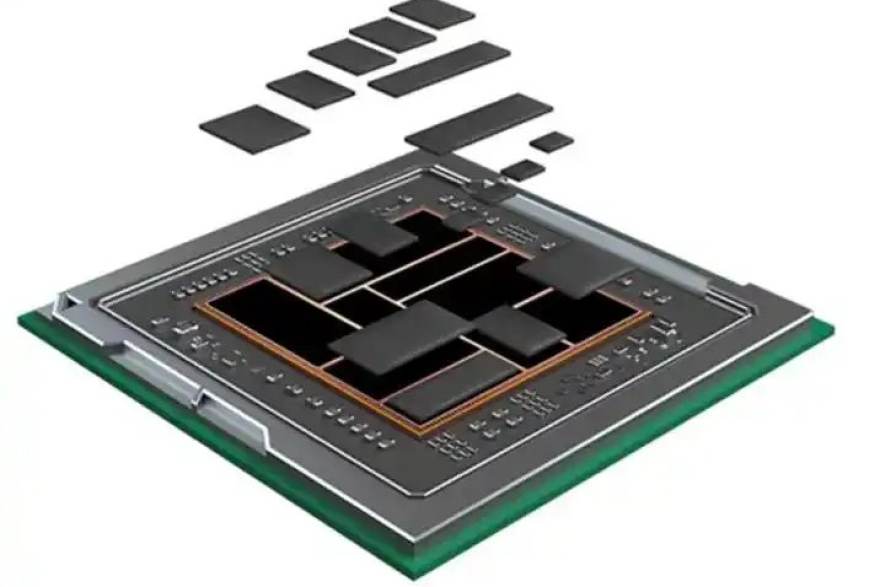
看球网认为,读榜单的正确姿势是先确定三条判断线,再回看排序。第一条是任务连续性:常开任务优先看待机功耗,间歇任务优先看唤醒延迟与峰值能效。第二条是模型演进速度:算法迭代快的团队应保留通用算力冗余,避免专用架构过早锁死。第三条是封装与散热约束:先进封装能缓解带宽瓶颈,但会抬高成本与设计复杂度,需要与整机热设计同步评估。
把这三条线叠加到榜单上,会发现一个反直觉的结论:能效排名靠前的方案未必是综合成本最优的方案。看球网在梳理公开资料时注意到,不少端侧项目最终选择第二梯队方案,原因正是通用性与工程可控性带来的隐性收益。榜单负责指出方向,边界负责划定适用范围,两者缺一不可。
后续看球网技术解读栏目会继续围绕存算一体与先进封装的交叉地带做参数级拆解,把这份榜单的每一项指标落到可复用的选型清单上。读者可通过看球网安卓、苹果iOS、Windows电脑版、Mac电脑版客户端同步查阅更新后的参数索引。
术语释义与阅读提示
能效甜点区指某架构在功耗与算力之间取得较优平衡的工作区间;失效边界指该架构性能或能效明显劣化的条件。看球网建议读者在引用本榜单时同时标注测试负载与功耗包络,避免脱离上下文比较单一数字。榜单中的梯队划分属于架构层面的一般规律,具体项目仍需以厂商公开规格书为准。
榜单把失效边界写出来这点很实在,比只给排名有用多了。
近存计算那段说到点子上了,片上存储一不够性能就掉得厉害。
想问下常开场景的待机功耗一般怎么测才比较有参考性?
通用GPU降频排第五不意外,生态好但长期跑确实费电。
封装和散热那条判断线建议单独出一期,整机设计太容易踩坑。
术语释义放最后挺友好,新读者不至于一上来就被甜点区绕晕。