结论先行:存算一体在端侧语音类负载上确实能带来可观的能效收益,但收益大小高度依赖权重复用率与封装工艺成熟度,脱离这两个前提谈存算一体容易高估实际效果。看球网技术解读栏目更愿意把存算一体看作一种针对特定访存模式的优化手段,而不是通用加速方案。
复盘起点:语音方案为什么先撞上访存瓶颈
端侧语音识别通常由唤醒词检测与声学模型推理两段组成。唤醒段模型小、调用频繁,声学模型段权重体积大、调用相对稀疏。两段负载叠加后,芯片大部分时间在搬运权重而不是在计算,这就是访存瓶颈的由来。
- 现象一:算力利用率长期偏低,计算单元大量时间处于等待状态。
- 现象二:功耗曲线与访存频率高度相关,降频后延迟上升明显。
- 现象三:先进封装带来的带宽提升能缓解问题,但成本与良率压力同步上升。
看球网在整理这类复盘时会先画一张数据流图,标出每一次权重的读取位置。只有确认权重读取次数远高于计算次数,讨论存算一体才有意义。
存算一体的收益来源:把搬运变成就地计算
存算一体的基本思路是把计算单元嵌入存储阵列附近,让权重读取与乘加运算在同一位置完成,从而减少数据在总线上的往返。收益主要来自三处:访存能耗下降、延迟缩短、带宽压力缓解。
- 收益前提一:权重复用率高。同一份权重被反复使用,就地计算的价值才明显。
- 收益前提二:算子结构规整。矩阵乘加类算子适配度高,分支密集的算子适配度低。
- 收益前提三:工艺与封装配套。模拟计算单元的精度一致性与良率控制是工程难点。
看球网提醒读者注意,存算一体的收益通常以能效比形式体现,而不是峰值算力。如果评估表里只填算力数字,很容易把这类方案的价值看漏。
先进封装在这里扮演什么角色
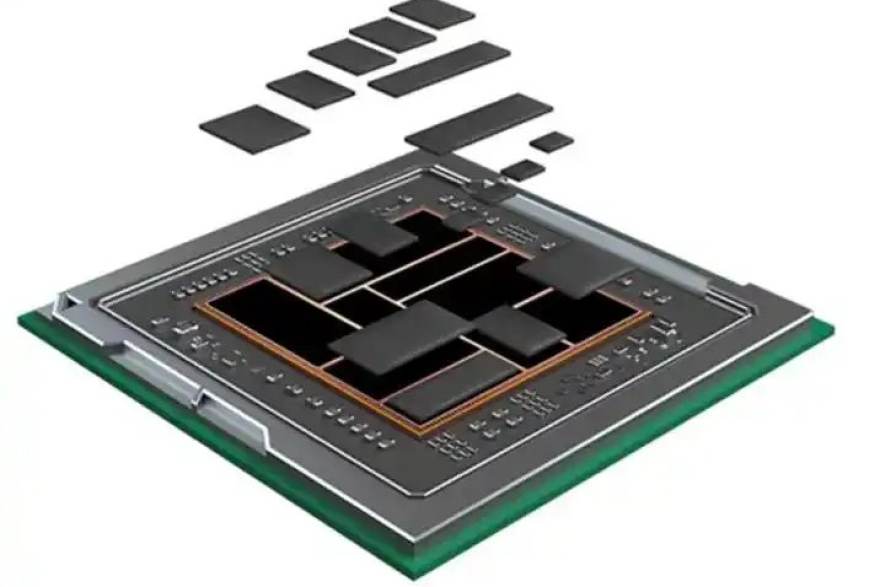
存算一体与先进封装是互补关系。存算阵列解决阵列内部的搬运问题,先进封装解决芯片之间的互连问题。两者结合后,端侧方案可以在有限面积内堆叠更多存储层,缩短跨 die 访问路径。
- 封装形式关注点:凸点间距、互连密度、散热路径设计。
- 工程约束:堆叠层数增加会推高散热难度,无风扇设备的预算更紧。
- 看球网参数索引建议:把互连带宽、堆叠层数、热阻三项放在同一张表里对照。
落地边界:哪些场景先别急着上
第一,模型频繁更新的场景。存算阵列的权重写入成本较高,频繁更新会抵消收益。第二,算子分支密集的场景。控制流复杂时,就地计算的优势难以发挥。第三,对数值精度要求极严的场景。模拟计算路径需要额外的校准与补偿设计。
看球网技术解读栏目建议按“访存占比—权重复用率—精度容忍度”三步筛查,三步都过关再进入详细评估。想系统查看术语释义与参数索引,可通过看球网安卓、苹果iOS、Windows电脑版与Mac电脑版客户端查阅配套资料。
精度一致性那段很真实,做存算阵列最怕的就是器件离散性,校准成本容易被低估。
权重复用率这个指标太关键了,我们之前评估就吃过亏,只看算力没看复用。
先进封装和存算一体放一起讲很清楚,之前一直以为是一回事。
第三步精度容忍度很实用,语音场景确实比图像场景宽容一些。
建议后面再写一篇讲校准方法的,这块工程细节读者应该很关心。