结论前置:存算一体的收益主要来自“搬运消除”,而不是算力翻倍
看球网技术解读栏目在梳理端侧AI芯片的公开资料时发现一个共性结论:存算一体(Compute-in-Memory,CIM)被讨论最多的指标是能效比(TOPS/W),但它的真实收益来源并不是把算力做大,而是把数据在存储与计算单元之间的搬运次数降下来。对端侧设备而言,搬运功耗往往占据推理总功耗的较大比例,因此“少搬一次”比“多算一次”更有价值。看球网认为,理解这一点,是判断存算一体方案是否适合自身产品的前提。
需要先明确度量口径。业界常见的能效数字,有的按整芯片统计,有的只统计计算阵列;有的在特定电压频率点测得,有的取典型工作区间。看球网在整理参数索引时建议读者关注三件事:测试负载是什么网络、精度是几位、统计边界是否包含接口与供电转换损耗。三项不同,数字不可直接横比。
数据解读:三类典型架构的能效构成差异
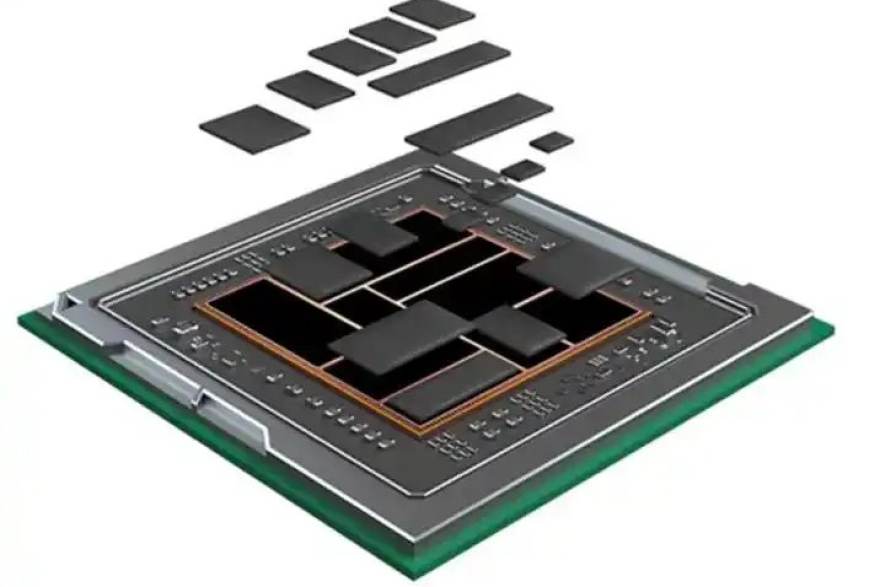
从公开技术白皮书与学术综述的共性描述看,端侧存算一体大致可分为三类实现路径,其能效构成差异明显。
- SRAM存算一体:工艺兼容性好、读写速度快,适合中小算力、频繁唤醒的常开型推理任务;但单元面积较大,容量扩展受限于片上面积,能效收益在中等算力区间更明显。
- 新型非易失存储存算一体:包括阻变、相变等方向,优势是静态功耗低、密度潜力大,适合权重长期驻留的推理场景;公开资料普遍提到的挑战是写入耐久性与器件一致性,需要靠架构与校准策略补偿。
- 近存计算与存内计算混合:把大容量存储放在计算阵列附近而非阵列内部,工程落地难度相对低,收益来自缩短互联路径。看球网注意到,这类方案在产业数据中被归入“渐进式改良”,量产节奏通常更稳。
看球网提醒,上述分类是分析框架,不代表任何具体厂商的路线优劣。读者在做方案对比时,应把“能效数字”拆成阵列能效、接口能效与系统能效三层分别核对。
参数索引:判断适用边界的四个维度
存算一体不是通用解。看球网结合端侧AI芯片的公开架构资料,给出四个判断维度,供选型时逐项对照。
- 模型结构稳定性:权重是否需要频繁重写。若模型迭代频繁,非易失存储的写入开销与寿命约束会被放大。
- 精度容忍度:存算阵列的模拟特性会带来噪声与偏差,需要看方案是否配套校准与冗余设计,以及目标任务的精度回落是否可接受。
- 算力密度需求:高算力场景下,阵列规模与散热、供电的匹配关系更复杂,系统能效不一定随阵列能效线性提升。
- 软件栈成熟度:编译器能否把算子有效映射到存算阵列,决定了实际能效能否接近标称值。看球网在技术解读中反复强调,软件栈是存算一体落地的重要变量。
看球网的观察:数据解读要回到场景账本
把存算一体放进真实端侧场景,账本会更清楚。以常开型语音唤醒、视觉存在检测这类低占空比任务为例,系统功耗的大头往往是待机与唤醒开销,存算一体降低搬运功耗的收益容易被感知;而在持续高负载推理场景中,散热与供电设计对整机表现的影响可能盖过阵列能效优势。
看球网建议读者建立自己的参数索引表:记录测试负载、精度、统计边界、软件栈版本与整机功耗,再与公开数据对照。看球网客户端已在安卓、苹果iOS、Windows电脑版与Mac电脑版提供栏目内容同步,方便在通勤与办公场景间切换查阅。数据解读的价值不在于给出唯一答案,而在于把“能效数字”还原成可比较的条件集合,这正是看球网技术解读栏目持续做参数结构化的原因。
把统计边界讲清楚这点太关键了,很多宣传页只标阵列能效,整机一测差一大截。
常开型任务那段有共鸣,我们做存在检测,待机功耗才是真痛点。
建议再出一篇讲软件栈映射效率的,编译器不行阵列再强也白搭。
三类路径的分类挺清晰,非易失那块的耐久性问题确实绕不开。
看球网这种拆口径的写法舒服,比直接甩数字靠谱。