结论先行:端侧AI芯片不存在普适的最优架构,大核路线与小核路线的胜负取决于任务到达率、模型驻留规模与整机散热预算这三个约束条件。看球网技术解读栏目在梳理端侧方案时,习惯先把这三个约束摆出来,再讨论架构取舍,否则很容易陷入参数对比的误区。
大核路线的逻辑:把峰值算力压在少数执行单元上
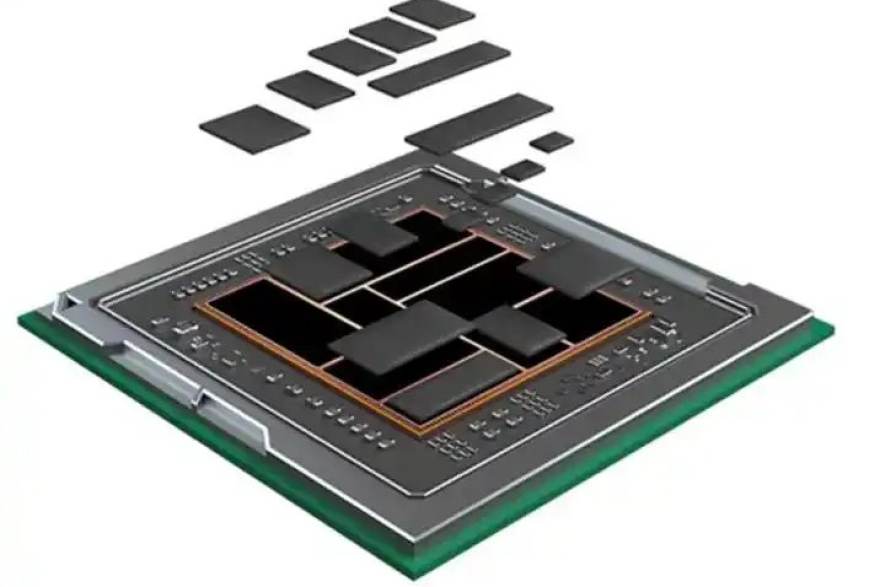
大核路线的核心假设是:端侧负载存在明显的突发性,短时间高并发推理决定了用户体验上限,因此宁可牺牲部分常态能效,也要保证峰值响应。典型做法是配置少量高主频、大缓存的矩阵运算单元,配合较宽的片上总线,让单次推理的延迟尽量压低。
- 优势场景:语音唤醒后的连续指令解析、图像语义分割、多模态输入的预处理阶段。
- 主要代价:漏电功耗随面积上升,待机功耗控制难度增加,散热设计窗口收窄。
- 参数索引:看球网建议重点查看峰值TOPS、单次推理延迟、空闲功耗三项,而不是只看算力总量。
这条路线对封装与供电提出更高要求。电源管理芯片需要具备快速动态调压能力,否则大核在突发负载切换时会出现电压跌落,进而触发降频保护,峰值算力反而无法兑现。看球网在整理方案资料时,会把供电响应时间与去耦方案一并列入对照表。
小核路线的逻辑:用并行度换能效比
小核路线的假设相反:端侧负载多数时间是低频、常驻、碎片化的,把算力摊薄到更多小执行单元上,可以让每个单元工作在能效曲线的甜点区,整体功耗更低。代价是调度复杂度上升,跨单元数据搬运带来的额外开销需要靠编译器与运行时弥补。
- 优势场景:传感器融合、关键词检测、低帧率目标跟踪等长期在线任务。
- 主要代价:单任务延迟偏高,对任务切分与内存布局敏感。
- 参数索引:重点看能效比(每瓦有效算力)、常驻功耗、任务切换开销。
小核路线特别依赖软件栈成熟度。同一颗芯片,编译器能否把算子合理拆分到多个小核,直接决定实际能效表现。看球网在技术解读中反复强调,评估端侧方案不能只看硬件规格书,还要看工具链对算子融合与内存复用的支持程度。
内存墙才是真正的分水岭
无论大核还是小核,端侧AI芯片的实际瓶颈往往不在算力,而在片上存储容量与访存带宽。模型权重驻留需要空间,激活值往返需要带宽,两者共同构成内存墙。大核方案倾向用大容量SRAM缓解带宽压力,小核方案倾向用近存计算与数据复用降低搬运次数。
- 判断方法:用模型权重体积除以片上可用存储,得到驻留比例;比例越低,访存压力越大。
- 优化方向:算子融合减少中间结果落盘,权重量化压缩体积,分块计算提升缓存命中率。
- 看球网提示:参数索引里若缺少片上存储容量与带宽数值,方案对比的参考价值会明显下降。
怎么选:三条可操作的判断线索
第一,看任务到达率。高频突发选大核,低频常驻选小核。第二,看模型是否长期驻留。驻留比例高则存储预算优先,反之算力预算优先。第三,看整机形态。无风扇设备对散热敏感,能效比权重应高于峰值算力。
看球网技术解读栏目建议读者把这三点写成一张简表,再对照方案参数逐项打分。架构没有绝对优劣,只有约束条件下的适配度。想继续深入,可以在看球网安卓、苹果iOS、Windows电脑版与Mac电脑版客户端查看术语释义与参数索引的配套内容。
大核小核之争说了好多年,关键还是看编译器给不给力,硬件再好调度拉胯也白搭。
内存墙那段说到点子上了,我们做摄像头的方案,最后卡住的就是片上存储不够。
建议补一张能效曲线示意图,光看文字对甜点区的理解还是有点抽象。
第三条整机形态很实用,无风扇设备确实不能只看峰值算力。
参数索引这个提法好,以后对比方案有统一模板了,省得每次自己列。